[地端 LLM 實戰] RTX 5060 Ti 16GB 部署 Qwen 3.8 27B 評測:量化版本選型、MTP 投機解碼與 Gated DeltaNet 效能分析
要在 16GB 顯存的消費級顯示卡(如 RTX 5060 Ti)上部署 27B 至 35B 規模的大語言模型,記憶體配置與參數調校是影響實用性的關鍵。先前因為測試 MiniMax H3 音視訊生成,後台的 ComfyUI 常駐佔用了約 12.9GB VRAM,因此在進行 LLM 評測時,必須先停止 ComfyUI 服務以釋放完整顯存。
在將 16GB VRAM 完整留給 LLM 後,我針對 Qwen 3.8 27B 的多個量化版本以及 Ornith 35B MoE 進行了一週的壓力測試。本文紀錄實測數據、Gated DeltaNet 架構在 CPU Offload 下的效能折損、MTP 投機解碼的記憶體開銷,以及生產環境的啟動配置。
1. 測試環境與軟硬體規格
評測使用的本地硬體與軟體環境配置如下:
- CPU:Intel Core i7-13700(
llama.cpp設定 6~8 threads) - RAM:23GB DDR5(加上
/data磁碟 32GB Swap) - GPU:NVIDIA GeForce RTX 5060 Ti 16GB(實際可用 VRAM 約 16,311 MiB,Blackwell 架構
sm_120) - 儲存:NVMe SSD (
/data) - 推理引擎:
llama.cppCUDA build(b10499升級至b10606/ commit6036c635e) - CUDA 版本:12.8
- 常用啟動參數:
-fa on、KV Cacheq4_0、--jinja、--reasoning auto --reasoning-preserve
2. Gated DeltaNet 架構的全卸載限制
測試 Qwen 3.8 27B 時,第一個遇到的瓶頸是「部分層數卸載到 CPU(Partial Offload)」。
傳統 Transformer 模型在 VRAM 吃緊時,通常可以將部分 Layer 移至 CPU RAM 執行,雖然速度變慢但仍可維持運作。但在 Qwen 3.8 採用的 Gated DeltaNet 混合架構中,CPU Offload 會帶來嚴重的效能懲罰。
實測數據對比(同一 Prompt 生成 600 Tokens)
| # | 量化版本 | VRAM 卸載設定 | Context Size | 生成速度 | MTP 接受率 | VRAM 駐留 |
|---|---|---|---|---|---|---|
| A | UD-IQ4_XS (14.25G) | -ngl 99(GPU 全卸載) |
68K | 39.9 tok/s | 49% | 15,738 MiB |
| B | UD-IQ4_XS (14.25G) | -ngl 58(部分卸載至 CPU) |
92K | 13.0 tok/s | 50% | 15,460 MiB |
| C | UD-IQ3_XXS (11.90G) | -ngl 99(GPU 全卸載) |
92K | 43.2 tok/s | 47% | 14,278 MiB |
| D | UD-IQ3_XXS (11.90G) | -ngl 99(GPU 全卸載) |
144K | 42.3 tok/s | ~50% | 15,682 MiB |
原因分析
當設定 -ngl 58 時,生成速度從 39.9 tok/s 降至 13.0 tok/s(下滑近 70%)。
主要原因在於 Gated DeltaNet 架構高度依賴 GPU 上的 Fused Kernels。一旦有層數落入 CPU,融合計算核心便無法發揮作用,且層間計算必須頻繁透過 PCIe 進行 GPU 與 CPU 的同步等待。因此在該架構下,選擇能在 GPU 內完全卸載(-ngl 99)的較低量化版本,實測效能優於較高量化但部分 Offload 的配置。
3. Qwen 3.8 27B Q4 量化版本比較
在確定必須全卸載的前提下,我在 16,311 MiB VRAM 限制內掃描了四個 Q4 量化變體:
| 評測指標 | Bucoid Uncensored | Huihui Abliterated | 官方 Unsloth | Heretic-Ara-MTP |
|---|---|---|---|---|
| 檔案大小 | 13.91 GB | 14.40 GB | 14.25 GB | 14.33 GB |
| 最高穩定 Context | 92K | 72K(長文發生 OOM) | 76K | ~88K(估算) |
| 空載生成速度 | 49.8 tok/s | 34.8 tok/s | 39.9 ~ 41.0 tok/s | 未測試 |
| 帶 14K Context 生成 | 49.1 tok/s | ~33.0 tok/s | 33.0 tok/s | 未測試 |
| Prompt 處理 (PP) | 846 tok/s | 819 tok/s | 726 tok/s | — |
| MTP 平均接受率 | 79% | ~50% | 62% | — |
| VRAM 殘餘預留 | 860 MiB | 433 MiB | 573 MiB | ~100 MiB |
| 結論 | 採用 | 不推薦 | 備用 | 不推薦 |
Huihui 變體 OOM 狀況復盤
Huihui 變體模型檔較官方版大約 150MB,導致 VRAM 剩餘空間壓縮至 433MB。在處理包含 9,728 tokens 的 Prompt 時,llama.cpp 執行 mul_mat_q 因無法取得足夠計算緩衝而觸發 CUDA Out of Memory,造成服務崩潰。
這表示在 llama.cpp 中,VRAM 預留空間若低於 500MB,容易在長 Prompt Decode 時發生不穩定。
4. 參數設定:--no-warmup 與 MTP 記憶體開銷
測試過程中發現兩項影響系統穩定度的設定細節。
4.1 --no-warmup 的動態分配陷阱
llama.cpp 的 VRAM 分配分為三個階段:
    graph TD
    A["1. 載入模型權重 (如 13.06 GB)"] --> B["2. 建立 Context (KV Cache)"]
    B --> C["3. 首次 Decode (Flash-Attn Workspace)"]

    style A fill:#1e293b,stroke:#3b82f6,color:#fff
    style B fill:#1e293b,stroke:#3b82f6,color:#fff
    style C fill:#1e293b,stroke:#ef4444,color:#fff
若使用 --no-warmup 參數,第 3 階段(Flash-Attention 工作區)會延遲到接收第一個請求時才分配。這會導致模型載入時顯示成功,但在實際進行首次推理時因記憶體不足而瞬間崩潰。建議生產環境保留 Warmup 流程以提前驗證 VRAM 足夠。
4.2 MTP (Multi-Token Prediction) 的記憶體開銷
MTP 投機解碼能提升解碼吞吐量,但草稿頭需要額外佔用約 1.4GB 權重與 Draft KV Cache。
在 16GB 顯存下:
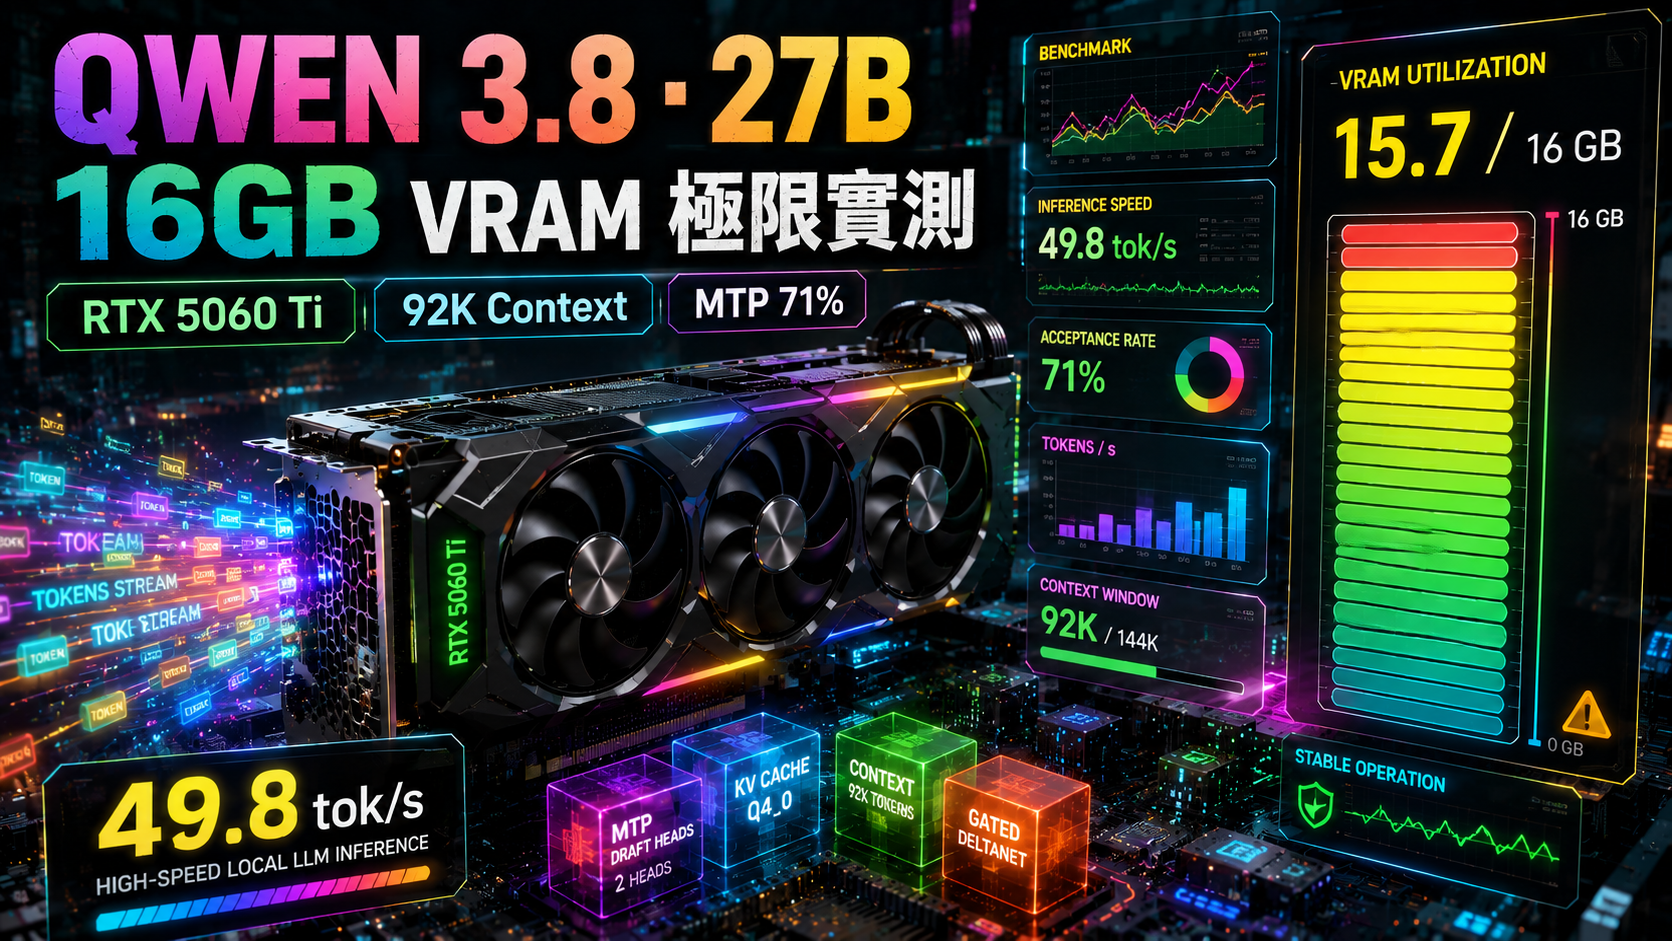
- 開啟 MTP:最大 Context 上限約 76K~92K,生成速度為 41.0 ~ 49.8 tok/s。
- 關閉 MTP:Context 可擴充至 120K,但生成速度降至 26.7 tok/s(速度降低約 35%)。
權衡程式碼生成與 Agent 互動的回應速度,選擇保留 MTP 並採用 Bucoid IQ4_XS (92K Context) 配置。
5. Ornith-1.5-35B-A3B MoE 評測比較
做為對照組,我也測試了 Ornith-1.5-35B-A3B-APEX-MTP-I-Mini(36B MoE 架構,每 token 激活 3B)。
數據表現
- 空載生成速度:關閉 MTP 下達到 108.4 tok/s;在 128K Context 滿載下為 62.5 tok/s。
- Prompt 處理 (PP):最高達 1,862 tok/s。
限制說明
- MTP 效益極低:因 I-Mini 為極致量化版本,草稿頭精度較低,MTP 接受率僅 10.5%。開啟 MTP 反而使速度降至 67 tok/s,因此測試時必須關閉 MTP。
- 程式碼生成表現:在複雜程式碼重構與邏輯推理任務上,I-Mini 量化的精準度明顯低於 Qwen 3.8 27B IQ4_XS。
Ornith 適合對回應時間要求極高且任務較單純的場景;若需要高品質的程式碼生成,Qwen 3.8 27B 仍是較穩妥的選擇。
6. 生產環境部署腳本與紀錄
目前採用的 start-llama-server-4bit-original.sh 啟動指令如下:
1 |
|
📌 關鍵特性:88k ctx、MTP 推測解碼、draft KV q4_0、預設關思考。執行
./start-llama-server-4bit-original.sh即可啟動。
實際長跑統計(n=54 筆請求)
- 生成速度 (TG):中位數 37.9 tok/s,平均 38.3 tok/s。
- Prompt 處理 (PP):大 Context (≥8K tokens) 讀取中位數 759 tok/s。
- MTP 草稿接受率:平均 71%。
- 長文測試:處理 62,188 tokens 的 Prompt 耗時 100 秒(618 tok/s),背載 62K Context 下生成速度保持在 31.0 tok/s。
7. 2026/09/04 補充:16GB VRAM 專屬優化版(tooltd IQ4_XS)實測
社群作者 tooltd 釋出了專為 16GB VRAM 邊界條件微調權重分佈的量化版本:tooltd/Qwen3.8-27B-IQ4-XS-16GB-VRAM-GGUF。
模型特性與量化技術亮點
- ZB-ZipBrain 混合精度演算法:不同於傳統齊頭式的量化切分,該模型採用「率失真邊際成本(Rate-Distortion Marginal Cost)」結合重要性矩陣(imatrix)校準,自動搜尋每個 Tensor 的 Pareto 最佳 BPW「甜點位」,在不犧牲推論品質的前提下極致壓縮模型體積。
- 針對 16GB 顯存精準打磨(ZB4.00-MIN-v5):
- 體積僅 12.79 GB(比一般 Q4_K_M 的 15.93GB 節省超過 3GB 顯存),為長 Context 與 Flash-Attn Workspace 騰出了充足的空間。
- 輸出層強化:
output.weight提升至Q6_K高精度,改善了程式碼生成與 One-shot 輸出的穩定度與精準性。 - v5 視覺與輸出穩定度校準:結合 Pelicanmaxxing 進行反覆調優,有效減少小參數精度損失可能導致的邏輯幻覺或過度思考。
- 實測體感:換上
Qwen3.8-27B-ZB4.00-MIN-v5-IQ4_XS.gguf跑日常開發與 Code Agent 任務,生成流暢度與穩定性明顯優於先前的版本。
最新啟動配置
1 | # Start llama-server (Qwen3.8-27B ZB4.00-MIN-v5 IQ4_XS, 16GB VRAM target) |
調參亮點解析
- 記憶體鎖定與穩定性:加入
--load-mode mlock鎖定記憶體分頁,避免系統記憶體置換帶來的突發延遲。 - Batch 吞吐加大:將
--batch-size與--ubatch-size調升至384,在長 Prompt Prefill 階段的吞吐處理速度有明顯改善。 - Context 拓展至 92K (94208):搭配
-ctk q4_0與-ctv q4_0,顯存控制極度緊湊且安全,完整壓在 16GB 顯存安全水位內。 - Jinja 思考強度適中:保留
--reasoning-preserve並搭配--chat-template-kwargs '{"reasoning_effort": "medium"}'(作者亦特別推薦 medium),兼顧推理深度與回覆速度,避免模型在 Agentic 工作流中過度思考造成卡頓。
實戰寫code開發與 Agent 體感小結
在實際寫 code 的場景下,將 ZB4.00-MIN-v5 搭配 SDD(Spec-Driven Development) 技能與各類 Agent 擴充能力(Superpowers)使用:
- 任務交付能力:邏輯理解與代碼生成相當紮實,在明確規格與架構約束下,確實能勝任日常開發與重構任務,是完全「能幹活」的地端主力。
- 速度權衡:在單張 16GB 消費級顯卡(RTX 5060 Ti)全卸載下,吞吐約維持在 38~41 tok/s。雖然整體生成與回覆節奏依然比不上動輒數百 tok/s 的頂級雲端商用 API,但對於追求完全離線、資料隱私零外流、無 Token 成本焦慮的開發者來說,這個表現已經達到了非常實用的甜點平衡。
8. 地端部署決策樹
根據測試經驗整理的量化與配置決策流程:
    flowchart TD
    Start["開始:檢視地端 VRAM 空間"] --> CheckVRAM{"可用 VRAM >= 16GB?"}

    CheckVRAM -- 否 --> LowVRAM["建議選擇 14B 以下模型"]
    CheckVRAM -- 是 --> CleanEnv["停止背景顯存服務 (如 ComfyUI)"]

    CleanEnv --> ModelChoice{"應用情境需求"}

    ModelChoice -- 極致速度 / 輕量任務 --> Ornith["Ornith 35B MoE (關閉 MTP)"]
    Ornith --> OrnithResult["128K Context @ 62~108 tok/s"]

    ModelChoice -- 高品質生成 / Code Agent --> QwenChoice["Qwen 3.8 27B 家族"]

    QwenChoice --> QuantRule{"量化版本選擇"}
    QuantRule -- 需要 144K 超長 Context --> IQ3["UD-IQ3_XXS (全卸載)"]
    QuantRule -- 速度與品質平衡 --> IQ4["tooltd / Bucoid IQ4_XS (16GB 優化版)"]

    IQ4 --> OffloadCheck{"是否能夠 100% 全卸載至 GPU?"}
    OffloadCheck -- 否 (-ngl < 99) --> Penalty["⚠️ Gated DeltaNet CPU 瓶頸,速度降至 13 t/s"]
    OffloadCheck -- 是 (-ngl 99) --> FinalSuccess["✅ 達成 92K Context @ 41 tok/s (MTP 71%)"]

    style FinalSuccess fill:#064e3b,stroke:#10b981,color:#fff
    style Penalty fill:#7f1d1d,stroke:#ef4444,color:#fff
9. 總結與調參建議
- 維持 100% GPU 全卸載:在 Gated DeltaNet 架構下,避免任何 Layer 落在 CPU。若顯存不足應調低量化版本而非減少卸載層數。
- 預留 VRAM 緩衝:建議保持 500MB 以上可用顯存,避免長 Prompt 在 Decode 階段崩潰。
- 保留 Warmup 流程:避免
--no-warmup延遲顯存配置而掩蓋動態分配問題。 - 評估 MTP 效益:高接受率模型(如 Qwen 3.8)建議開啟 MTP;低接受率模型則應關閉 MTP 節省記憶體。
- 推薦組態:16GB VRAM 顯卡目前最推薦採用
tooltd/Qwen3.8-27B-IQ4-XS-16GB-VRAM-GGUF(ZB4.00-MIN-v5)搭配 92K Context (94208)、MTP 與--load-mode mlock,可取得極佳的生成品質與流暢體感。