繼先前在 RTX 5060 Ti 16GB 上折騰完 MiniMax H3 音視訊生成Qwen 3.8 27B 地端部署 後,阿里雲 Qwen 團隊剛發布了開源多模態生圖旗艦模型 Qwen Image 2.1。這款模型號稱具備原生 2K 輸出、支援多圖一致性與強悍的多模態視覺理解。社群最關心的莫過於:16GB 顯存的甜品卡到底扛不扛得住 7B DiT 加上 8B Qwen3-VL 文本編碼器的雙重壓力?會不會一按生成就直接 CUDA OOM 爆顯存?

我第一時間拉下官方權重,透過 ComfyUI 搭配 INT8 ConvRot 量化展開極限壓測。本文將完整記錄這套環境的部署配置、4.2 MP 原生 2K 解析度實測、ComfyUI 雙工作流(T2I 文生圖與多圖虛擬換裝),以及橫跨東方神話、史詩魔幻全景到 9:16 商業海報的真實 Prompt 調校與渲染表現。
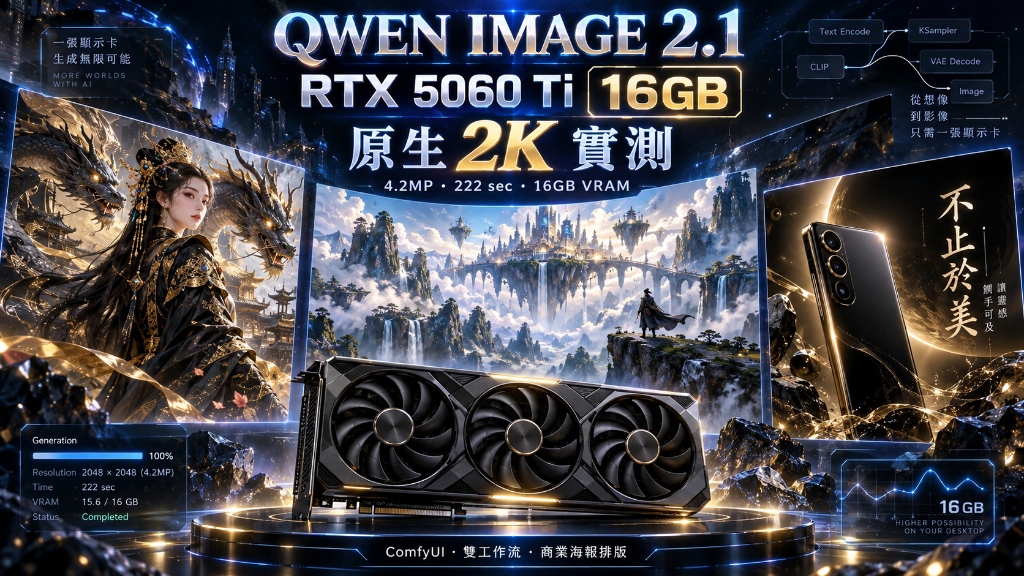
RTX 5060 Ti 16GB × Qwen Image 2.1:原生 2K 算圖、ComfyUI 雙工作流與商業海報排版實測封面


1. 測試環境與模型選型:16GB 顯存的生存平衡術

在消費級顯示卡上部署視覺大模型,最棘手的就是顯存開銷。Qwen Image 2.1 採用 7B 參數的單流擴散 Transformer(Single-Stream DiT)作為生成核心,搭配 Qwen3-VL (8B) 負責深度語意與多模態理解。如果直接載入原始 BF16 權重,光是雙模型權重本體與 Latent 運算快取就會輕鬆衝破 24GB,在 16GB 顯卡上必定直接閃退。

技術權衡:為什麼選擇 INT8 ConvRot?

在決定量化版本時,我評估了兩種主流路線:

  • GGUF Q4 路線:顯存雖然能壓到 10GB 以下,但在 ComfyUI 剛跟進新架構的初期,部分自訂取樣節點對 GGUF 的支援容易出小毛病。
  • INT8 ConvRot 路線:透過旋轉矩陣變換消除特徵離群值,在維持極低量化噪點的同時,直接將模型大小砍半,並且原生相容於標準 Safetensors 載入流程。

最終我採用「雙 INT8 核心 + 原生 BF16 VAE」的折衷方案:將 DiT 與 Text Encoder 雙雙轉為 INT8 ConvRot,而負責最終解碼出圖的 VAE 則堅持保留 BF16,確保畫面色彩寬容度不被量化噪點破壞。

硬體與軟體環境配置

項目 配置規格
GPU 顯示卡 NVIDIA GeForce RTX 5060 Ti 16GB(Blackwell 架構,實際可用 VRAM 約 16,311 MiB)
👉 在蝦皮購物選購 RTX 5060 Ti 16G 優惠價
CPU 處理器 Intel Core i7-13700
主機環境 Ubuntu Server(運行於 Proxmox VE 虛擬機,PCIe 直通 GPU)
系統記憶體 VM 配置 32GB RAM
操作介面 ComfyUI(官方 Qwen Image 2.1 T2I 範本工作流)
輸出格式 PNG、8-bit、sRGB

模型載入組合

模型類型 檔案名稱 選型邏輯與實測考量
Diffusion Model qwen_image_2.1_int8_convrot.safetensors 核心 7B DiT 採用 INT8 ConvRot,大幅壓低 Latent 計算時的峰值顯存
Text Encoder qwen3vl_8b_int8_convrot.safetensors 8B 視覺語言編碼器採用 INT8,精準保留多模態長文本理解能力
VAE 解碼器 qwen_image_2.1_vae_bf16.safetensors 維持原生 BF16 精度,防止解碼過程產生色階斷層與暗部噪訊

這套配置成功把整條生圖管線的常駐顯存壓縮在約 14.2GB,替 4.2 MP 原生 2K 解析度的巨大 Latent 運算留出了足夠的安全緩衝。


2. 核心參數與避坑心法:CFG 1.0 的底層思維轉換

習慣使用 SDXL 或 Flux 的開發者,進入 Qwen Image 2.1 後最容易踩坑的就是 CFG(Classifier-Free Guidance)

關鍵參數設定

參數 實測推薦值 運作特性說明
CFG 1.0 官方標準基準值。計算負載最低且畫面最自然
Steps 40 成品輸出步數,細節銳利度與生成耗時的最佳甜蜜點
Sampler Euler 收斂平穩且物件邊界乾淨
Scheduler Simple 與 Euler 搭配非常合拍
Denoise 1.0 文生圖標準設定
Batch Size 1 16GB 顯卡單張生成最穩妥,避免爆顯存

重要避坑須知:Negative Prompt 在 CFG 1.0 下形同虛設

許多人習慣在負面提示詞(Negative Prompt)塞滿「bad anatomy, blurry, extra limbs」,卻發現模型完全不理會。說白了,在 CFG = 1.0 的數學定義下,模型只純粹依照正面條件進行單向導引,正向與無條件預測之間的差值為零,負向提示詞根本沒有參與任何計算

因此,實務上有兩條摸索出來的血淚經驗:

  1. 所有限制條件全部改寫進正向提示詞:不必在負面塞「bad hands」,請直接在正面明確指定「both hands are clearly visible and anatomically correct」。
  2. 切勿為了啟用 Negative 而盲目拉高 CFG:隨意將 CFG 提高到 2.0 以上,除了讓每一步的推理耗時倍增之外,畫面極容易出現過度銳化、色彩死黑與油畫感。官方既然以 CFG 1.0 作為基準調校,順應其模型特性撰寫強約束的正面 Prompt 才是正道。

什麼是「原生 2K 輸出」?4.2 MP 解析度對照

很多朋友直覺以為 2K 只是把長邊拉到 2048px,但 Qwen 官方認定的原生 2K 規格,計算標準在於總像素量達到約 4.2 MP(MegaPixels)

官方建議比例與標準解析度對照如下:

比例 官方推薦解析度 總像素量
1:1 2048 × 2048 4.19 MP
4:3 2400 × 1792 4.30 MP
3:4 1792 × 2400 4.30 MP
3:2 2528 × 1696 4.29 MP
2:3 1696 × 2528 4.29 MP
16:9 2752 × 1536 4.23 MP
9:16 1536 × 2752 4.23 MP

[!TIP]
ComfyUI 節點排坑技巧:使用 ResolutionSelector 節點時,若設定 16:9、4.2 MP 且倍數(Multiple)為預設的 8,節點可能會計算出 2800 × 1576 這類非標準尺寸。建議手動將參數改設為 Megapixels: 4Multiple: 32,長寬對齊 32 的倍數,運算效率更高且更貼合官方預訓練尺寸。


3. ComfyUI 雙工作流拆解:標準 T2I 與多圖參考虛擬試衣

為了讓大家能直接在地端復現,我將這次實測使用的兩套核心 ComfyUI 工作流整理出來。你可以直接點開下方的 JSON 代碼塊複製,並拖曳或貼入你的 ComfyUI 畫布中。

工作流一:標準 T2I(文生圖)基礎工作流

這是一套極簡且高效率的純文字生圖架構,採用官方推薦的單次編碼路徑:

  • 核心節點
    • UNETLoader:載入 qwen_image_2.1_int8_convrot.safetensors
    • CLIPLoader:載入 qwen3vl_8b_int8_convrot.safetensors(Type 務必設定為 qwen_image
    • VAELoader:載入 qwen_image_2.1_vae_bf16.safetensors
    • ResolutionSelector:自由選定 1:1、16:9 或 9:16,並輸出長寬至 EmptyLatentImage
    • TextEncodeQwenImage21:Qwen 專屬文字編碼器,解析度預設輸入 1024
    • KSampler:設定 Steps: 25~40CFG: 1.0Sampler: EulerScheduler: Simple
📋 點擊展開:工作流一(標準 T2I 文生圖)ComfyUI JSON 代碼
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
{
"13": {
"inputs": {
"aspect_ratio": "1:1 (Square)",
"megapixels": 1,
"multiple": 8
},
"class_type": "ResolutionSelector",
"_meta": {
"title": "解析度選擇器"
}
},
"461": {
"inputs": {
"filename_prefix": "Qwen_image_2.1",
"format": "png",
"format.bit_depth": "8-bit",
"format.input_color_space": "sRGB",
"images": [
"459:457",
0
]
},
"class_type": "SaveImageAdvanced",
"_meta": {
"title": "儲存影像(進階)"
}
},
"459:451": {
"inputs": {
"unet_name": "qwen_image_2.1_int8_convrot.safetensors",
"weight_dtype": "default"
},
"class_type": "UNETLoader",
"_meta": {
"title": "載入擴散模型"
}
},
"459:452": {
"inputs": {
"prompt": "Greyscale fashion editorial portrait of an avant-garde woman tilted upwards in profile, captured with striking high-contrast chiaroscuro lighting. She wears oversized, thick-rimmed circular black sunglasses with matte dark lenses, concealing her upward gaze. Her attire merges high couture with tactical abstraction: a high-necked structural dress tailored from heavyweight fabric featuring a disrupted optical camouflage pattern—interlocking oversized polka dots, pixelated stippling, and organic contour blotches in stark monochrome that mimic military disruptive patterns in a refined runway style. Around her shoulders, asymmetric pleated webbing and tailored cargo straps are integrated seamlessly into the garment’s architecture. In her gloved hand, she clutches a structured matte-leather geometric handbag accented with subtle tactical buckles, utility stitching, and dark brushed-metal hardware. Her skin texture is rendered with hyper-detailed clarity, sculpted by intense, razor-sharp studio key light and deep graphite shadows. The striking background is a vivid mixed-media graphic collage, composed of flat vibrant lime green planes, stark black and white overlapping circles, segmented semi-circles with bold zebra striping, dense micro-halftone dot matrices, and vector topographic contour lines. The clash between monochromatic disruptive camo elements on her clothing and the saturated, retro-futuristic pop-art backdrop creates an intense visual dissonance, emphasizing sharp silhouettes, paper cut-out edges, dynamic compositional balance, and clean graphic novel textures. Absolutely no text, no typography, no letters, no words, no numbers, no logos, no watermark, no captions, pure imagery only.",
"negative_prompt": "",
"resolution": 1024,
"clip": [
"459:453",
0
]
},
"class_type": "TextEncodeQwenImage21",
"_meta": {
"title": "Text Encode Qwen Image 2.1"
}
},
"459:453": {
"inputs": {
"clip_name": "qwen3vl_8b_int8_convrot.safetensors",
"type": "qwen_image",
"device": "default"
},
"class_type": "CLIPLoader",
"_meta": {
"title": "載入 CLIP"
}
},
"459:454": {
"inputs": {
"vae_name": "qwen_image_2.1_vae_bf16.safetensors"
},
"class_type": "VAELoader",
"_meta": {
"title": "載入 VAE"
}
},
"459:456": {
"inputs": {
"width": [
"13",
0
],
"height": [
"13",
1
],
"batch_size": 1
},
"class_type": "EmptyLatentImage",
"_meta": {
"title": "空白潛在影像"
}
},
"459:457": {
"inputs": {
"samples": [
"459:458",
0
],
"vae": [
"459:454",
0
]
},
"class_type": "VAEDecode",
"_meta": {
"title": "VAE 解碼"
}
},
"459:458": {
"inputs": {
"seed": 593103825222985,
"steps": 25,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1,
"model": [
"459:451",
0
],
"positive": [
"459:452",
0
],
"negative": [
"459:452",
1
],
"latent_image": [
"459:456",
0
]
},
"class_type": "KSampler",
"_meta": {
"title": "KSampler"
}
}
}

工作流二:進階 I2I 多圖參考與虛擬換裝(Virtual Try-On)

這套工作流充分展示了 Qwen Image 2.1 原生多模態編輯的威力。以往要做到「保留模特五官、身材與姿勢,將另一張商品圖的牛仔襯衫穿上去」,往往需要 ControlNet OpenPose 加上 Inpainting 與 IP-Adapter 複雜堆疊;而 Qwen Image 2.1 透過原生架構直接在文字編碼器中引用多圖:

  • 關鍵機制解析
    • 多圖自然語言指代TextEncodeQwenImage21 節點同時吃入 images.image_1(模特圖 portrait_model_denim.png)與 images.image_2(服裝圖 clothing_light_blue_denim_shirt.png),在 Prompt 中直接使用 <image1><image2> 精準指代!
    • Prompt 範例
      1
      Keep the character and pose in <image1> unchanged, put this light blue denim shirt from <image2> on the character, preserve the original facial features, hair, body shape and pose, the denim shirt fits naturally on body, realistic denim fabric texture, natural clothing folds, keep the original background and original lighting, high fashion editorial photography, sharp details
    • QwenImage21Cache(KV Cache 加速):這是一個極為關鍵的優化節點,能快取模型推理時的注意力特徵,大幅降低多圖輸入時的顯存負載與每步推理時間。
    • ComfySwitchNode:控制 Latent 是來自全新空白畫布還是由文字編碼器輸出的潛在特徵,靈活切換生成邏輯。
    • ImageCompare:方便在 ComfyUI 介面上拉動滑桿直觀比對換裝前後的細節差異。
📋 點擊展開:工作流二(多圖參考虛擬換裝)ComfyUI JSON 代碼
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
{
"13": {
"inputs": {
"aspect_ratio": "1:1 (Square)",
"megapixels": 1,
"multiple": 32
},
"class_type": "ResolutionSelector",
"_meta": {
"title": "解析度選擇器"
}
},
"461": {
"inputs": {
"filename_prefix": "Qwen_image_2.1",
"format": "png",
"format.bit_depth": "8-bit",
"format.input_color_space": "sRGB",
"images": [
"459:457",
0
]
},
"class_type": "SaveImageAdvanced",
"_meta": {
"title": "儲存影像(進階)"
}
},
"470": {
"inputs": {
"image": "portrait_model_denim.png"
},
"class_type": "LoadImage",
"_meta": {
"title": "載入圖片"
}
},
"472": {
"inputs": {
"compare_view": {
"__value__": [
"",
""
]
},
"image_a": [
"470",
0
],
"image_b": [
"461",
0
]
},
"class_type": "ImageCompare",
"_meta": {
"title": "圖像比較"
}
},
"475": {
"inputs": {
"image": "clothing_light_blue_denim_shirt.png"
},
"class_type": "LoadImage",
"_meta": {
"title": "載入圖片"
}
},
"459:451": {
"inputs": {
"unet_name": "qwen_image_2.1_int8_convrot.safetensors",
"weight_dtype": "default"
},
"class_type": "UNETLoader",
"_meta": {
"title": "載入擴散模型"
}
},
"459:453": {
"inputs": {
"clip_name": "qwen3vl_8b_int8_convrot.safetensors",
"type": "qwen_image",
"device": "default"
},
"class_type": "CLIPLoader",
"_meta": {
"title": "載入 CLIP"
}
},
"459:454": {
"inputs": {
"vae_name": "qwen_image_2.1_vae_bf16.safetensors"
},
"class_type": "VAELoader",
"_meta": {
"title": "載入 VAE"
}
},
"459:456": {
"inputs": {
"width": [
"13",
0
],
"height": [
"13",
1
],
"batch_size": 1
},
"class_type": "EmptyLatentImage",
"_meta": {
"title": "空白潛在影像"
}
},
"459:457": {
"inputs": {
"samples": [
"459:458",
0
],
"vae": [
"459:454",
0
]
},
"class_type": "VAEDecode",
"_meta": {
"title": "VAE 解碼"
}
},
"459:458": {
"inputs": {
"seed": 1070478148268574,
"steps": 25,
"cfg": 1,
"sampler_name": "euler",
"scheduler": "simple",
"denoise": 1,
"model": [
"459:469",
0
],
"positive": [
"459:474",
0
],
"negative": [
"459:474",
1
],
"latent_image": [
"459:468",
0
]
},
"class_type": "KSampler",
"_meta": {
"title": "KSampler"
}
},
"459:468": {
"inputs": {
"switch": false,
"on_false": [
"459:474",
2
],
"on_true": [
"459:456",
0
]
},
"class_type": "ComfySwitchNode",
"_meta": {
"title": "切換"
}
},
"459:469": {
"inputs": {
"device": "auto",
"dtype": "default",
"model": [
"459:451",
0
]
},
"class_type": "QwenImage21Cache",
"_meta": {
"title": "Qwen Image 2.1 Cache"
}
},
"459:474": {
"inputs": {
"prompt": "Keep the character and pose in <image1> unchanged, put this light blue denim shirt from <image2> on the character, preserve the original facial features, hair, body shape and pose, the denim shirt fits naturally on body, realistic denim fabric texture, natural clothing folds, keep the original background and original lighting, high fashion editorial photography, sharp details",
"negative_prompt": "",
"resolution": 0,
"clip": [
"459:453",
0
],
"images.image_1": [
"470",
0
],
"vae": [
"459:454",
0
],
"images.image_2": [
"475",
0
]
},
"class_type": "TextEncodeQwenImage21",
"_meta": {
"title": "Text Encode Qwen Image 2.1"
}
}
}

4. 實戰測試一:東方神話高密度人物與結構調校

測試一:極限複雜構圖初探

為了驗證 Qwen Image 2.1 對多重材質與複雜空間的整合力,我設計了一組高密度的東方神話場景:

  • 東方幻想女帝、身著黑金交織的刺繡禮服。
  • 身側環繞兩條東方神龍、背景為黃金宮殿。
  • 遠景融合深邃宇宙、星雲與日蝕天象。
  • 前景堆疊大量珠寶、金屬、發光蓮花與精密天文儀器。

初次生成表現
畫面的第一眼視覺張力下足了重本,黑金配色大氣,金屬反光與水晶折射的質感表現可圈可點。然而仔細審視下,也暴露了幾個常見問題:人物臉部在整體構圖中偏小;雙龍軀幹局部與後方宮殿柱子融在一起;手部線條與龍爪出現邊界不清的交疊。

測試二:結構約束注入(Prompt Engineering)

既然 CFG 1.0 下無法使用負向提示詞排除瑕疵,我直接在正向 Prompt 中追加幾何與空間的強約束語句:

1
2
3
4
5
The empress occupies approximately 45% of the image height.
Both hands are clearly visible and anatomically correct.
Each dragon has one clearly defined head, a long neck,
a continuous torso and readable claws.
Maintain clean object boundaries and coherent anatomy.

調整後的改善成果

  • 主體比例修正:女帝臉部比例明顯放大,五官神態細緻立體。
  • 解剖與邊界分明:雙龍擁有了完整的長頸與連續軀幹走向,龍爪與雲霧分離乾淨。
  • 空間層次分明:女帝、神龍、金色宮殿與星空形成了明確的前、中、後景深,金色飾品不再是一團混沌的高光貼圖。
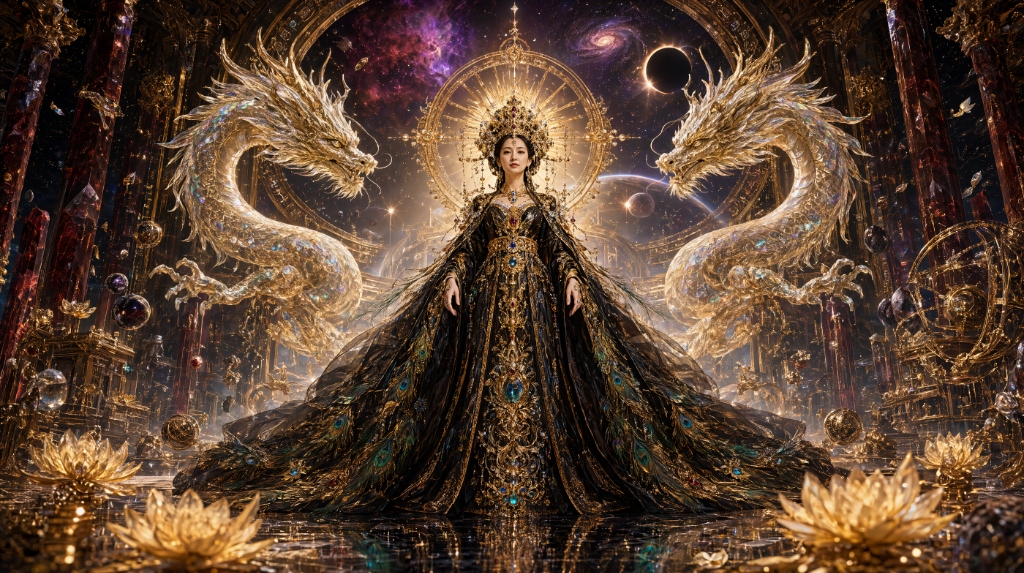
實測成果:Qwen Image 2.1 高密度東方神話場景(女帝與雙神龍)


5. 實戰測試二:16:9 史詩級魔幻全景與超大景深渲染

除了高密度人物主體外,為了考驗 Qwen Image 2.1 在超廣角電影鏡頭下的多層次景深控制力複雜生態要素整合力,我進一步測試了一組極致複雜的 16:9 奇幻世界開場畫面。

這組測試的關鍵在於:畫面中同時包含前景微距植物、極小比例人物(作為尺度對照)、中景浮空城堡、遠古森林鏡面湖泊、遠景雲海雪山、巨型星球以及盤旋於天空的巨龍。如果模型的空間語意理解力不足,極容易把這些元素混成一團雜亂的紋理。

實測成品展示
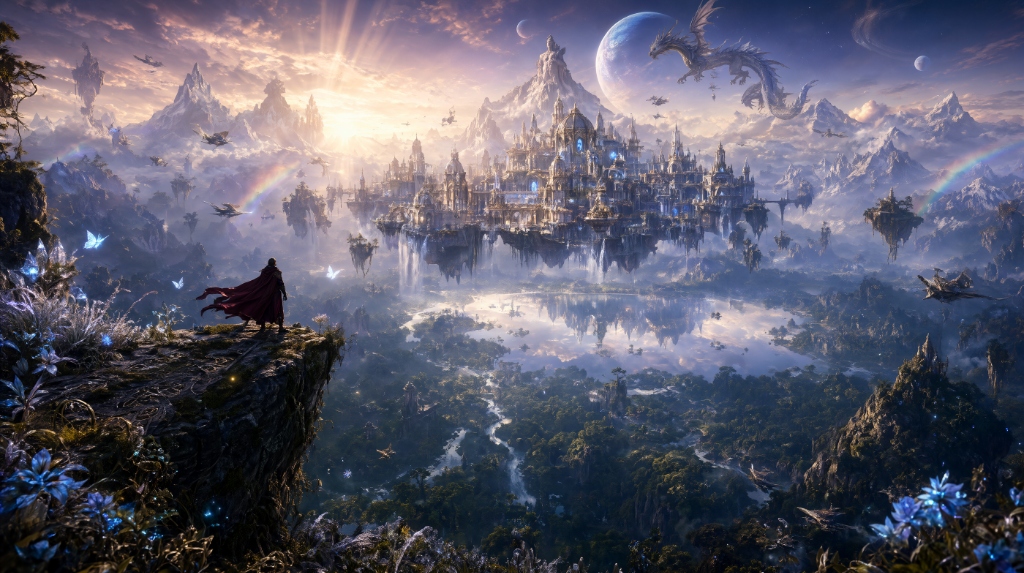
Qwen Image 2.1 實測 16:9 史詩級魔幻世界全景:失落王國與浮空城

▲ RTX 5060 Ti 16GB 實測出圖:16:9 史詩級魔幻全景,前景旅人、中景浮空城與遠景天空巨龍呈現出層次分明的壯麗景深。

完整實測提示詞(Prompt)

📋 點擊展開:16:9 史詩級魔幻全景提示詞(三層景深強約束)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
一幅氣勢磅礴、極度華麗的史詩級魔幻世界全景,16:9超寬幅電影構圖。攝影機位於高山懸崖邊緣,以超廣角俯瞰一個規模浩大的失落魔法王國。畫面必須具有清楚的前景、中景與遠景,展現數十公里深度的壯麗空間感。

前景是一座布滿青苔與銀白色古老符文的黑色岩石懸崖。懸崖邊生長著巨大的發光藍色花朵、透明水晶、金色藤蔓與隨風飄動的銀白草原。數隻發光蝴蝶飛過鏡頭,水滴、花粉與細小魔法粒子在空氣中閃爍。前景岩石、植物、水晶與露珠非常清晰,但不能遮擋中央主景。

一名披著深紅色長披風的孤獨旅人站在懸崖邊緣,背對鏡頭仰望遠方王國。人物只占畫面高度約8%,用來呈現世界的巨大尺度。披風在強風中向側面飛揚,人物身形完整、輪廓清楚,不需要露出臉部。

中景是一座漂浮在巨大山谷上方的魔法天空之城。城市由白色大理石、古銅色金屬、透明水晶與發光藍寶石建造,擁有數十座高聳尖塔、巨大圓頂、空中花園、拱形橋梁與層層相連的宮殿。所有建築具有合理結構、清楚輪廓與統一設計語言,不可變成隨機堆疊的裝飾紋理。

天空之城下方有數十座大小不同的浮空島嶼,每座島嶼底部都暴露出岩石、水晶礦脈與垂落藤蔓。多條巨大瀑布從浮空島流向深不見底的山谷,在空中化成發光水霧與彩虹。數艘優雅的魔法飛船穿梭於城市與浮空島之間,飛船大小符合遠近透視,不可雜亂重疊。

山谷底部是一片無邊無際的遠古森林,森林中散布著發光河流、湖泊、神殿遺跡、巨樹與薄霧。蜿蜒河流像銀色絲帶一樣穿過森林,最後流入遠方巨大的鏡面湖泊。湖面完整倒映天空之城、山峰、雲層與金色陽光。

遠景是數座穿越雲海的巨大雪山,山峰上矗立著古老巨像與殘破神殿。天空中漂浮著一顆巨大的藍色行星、兩輪細小月亮、淡紫色星雲與若隱若現的星環。一條體型龐大的東方天空神龍盤旋在最高山峰與雲層之間,龍的完整頭部、修長頸部、連續身軀、四肢、尾巴與雙翼輪廓清楚可辨,不與雲層或山峰融合。

破曉時分,金色晨光從遠方山脈之間穿透厚重雲層,形成巨大而清晰的丁達爾光柱。天空呈現深藍、紫羅蘭、粉紅與金色漸層。陽光照亮天空之城、瀑布與雲海,形成壯麗的金色輪廓光。暗部保留森林、岩石與建築細節,亮部不可過曝。

整個世界必須充滿生命與魔法,但保持清楚、合理、可閱讀的空間結構。每座建築、浮空島、瀑布、飛船、山峰與生物都有明確邊界。避免毫無意義的細節堆疊、物件融合、重複建築、扭曲透視或混亂紋理。

史詩、神聖、浪漫、夢幻、壯觀、令人敬畏,像一部耗資巨大的奇幻冒險電影開場畫面。電影級環境設計,超廣角鏡頭,強烈景深,空氣透視,體積光,雲霧分層,真實水體,精密建築,清晰材質,極致細節,高動態範圍,寫實幻想風格。

epic fantasy landscape, enormous magical kingdom, floating celestial city, waterfalls from floating islands, ancient forest, colossal mountains, celestial dragon, cinematic environment design, volumetric sunlight, atmospheric perspective, realistic water reflections, intricate architecture, breathtaking scale, fantasy adventure movie establishing shot, photorealistic, ultra-detailed, masterpiece, 16:9 panoramic composition, no text, no logo, no watermark

細節與空間表現評析

  1. 三段式景深層次鮮明(空氣透視與比例尺)
    • 前景微距:懸崖上的發光藍花、岩石青苔與水滴晶瑩剔透,紅披風旅人嚴格遵照「約佔畫面 8%」的比例定位,成為襯托整個世界宏偉尺度的視覺錨點。
    • 中景浮空城:白色大理石與藍寶石穹頂的建築結構嚴謹,瀑布跌落化為水霧與彩虹,完全沒有常見的建築隨機融化現象。
    • 遠景宇宙天象:穿越雲海的雪山、巨大藍色星環行星與右上角舒展雙翼的東方神龍,各自具備清晰邊界。
  2. 光影渲染極致(丁達爾體積光與水體倒影)
    • 晨曦從左側山巔破雲而出,散射出清晰逼真的丁達爾光柱(God Rays)。
    • 山谷底部的巨大鏡面湖泊完整倒映了浮空城堡與朝霞天空,折射與反射水體計算相當自然。
  3. 無負面提示詞下的複雜控制力
    • 再次驗證了在 CFG=1.0 下,透過明確指定「前景/中景/遠景」、「人物佔比」、「不可與雲層融合」等幾何與空間約束語言,能徹底引導 7B DiT 輸出秩序井然的超複雜畫面。

6. 極限性能壓測:4.2 MP 渲染耗時與顯存分析

在確認構圖品質後,我將解析度拉滿至 16:9、約 4.2 MP(2800 × 1576),進行 40 Steps 的極限性能壓測。

1
2
3
4
5
6
解析度:約 2800 × 1576 (16:9)
Steps:40
CFG:1.0
Sampler / Scheduler:Euler / Simple
實測耗時:222 秒(約 3 分 42 秒)
平均速度:約 5.55 秒 / Step

壓測收穫

  1. 零 OOM 穩定通關:在 16GB VRAM 的 RTX 5060 Ti 上,整段生成過程顯存維持在約 14.2GB 左右,全程沒有發生任何記憶體溢位。
  2. 算力與解析度的非線性關係:4.2 MP 的運算量相當龐大。以日常工作流來看,每張圖花費將近 4 分鐘並不適合拿來連續抽卡挑 Seed。

根據實測數據,我整理出不同像素級別的渲染耗時推估表:

輸出規格 總像素量 40 Steps 推估耗時 適用場景
約 1.0 MP(720P 級別) 1.0 MP 約 53 秒 快速打樣、測試 Prompt 與 Seed
約 2.35 MP(1080P 級別) 2.35 MP 約 118 秒 中度預覽、構圖確認
約 3.0 MP(2K 輕量) 3.0 MP 約 158 秒 社交媒體常規發布圖
約 4.2 MP(原生 2K) 4.2 MP 實測 222 秒 最終正式成品、高品質桌布、影片首幀

7. 實戰測試三:9:16 商業產品海報與繁體中文排版

除了東方神話大場景外,商業廣告設計也是檢驗模型實用性的關鍵考題。以往在開源生圖模型中,繁體中文與工業產品排版一直是個痛點 —— 常常圖生得不錯,但文字不是缺筆斷畫就是變成奇怪的異體字。

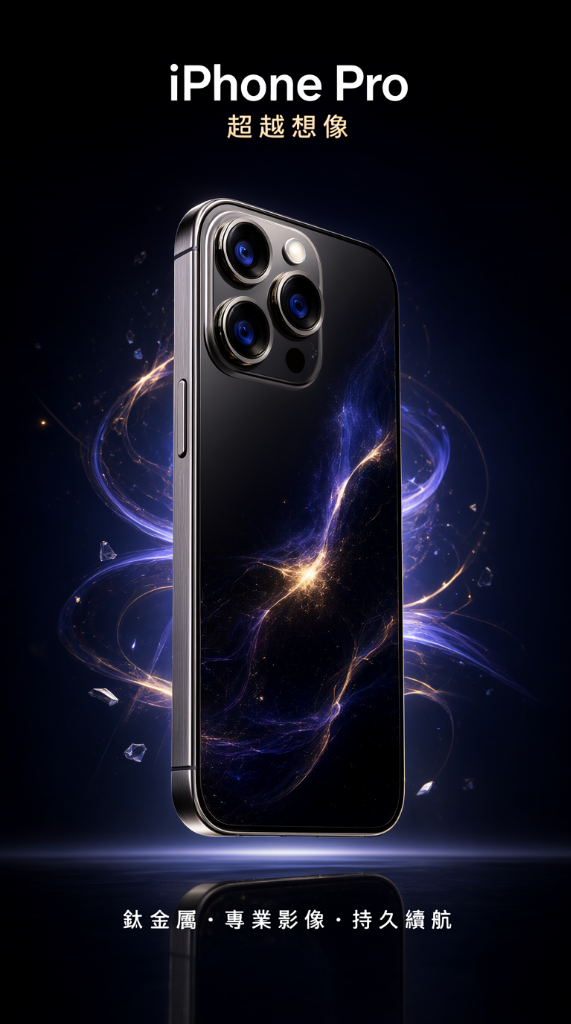
這次我使用 9:16 直式畫幅,要求 Qwen Image 2.1 產生一張極簡黑金科技風格的旗艦手機廣告海報:

  • 頂部英文品名iPhone Pro
  • 中文副標超越想像
  • 底部核心賣點鈦金屬 · 專業影像 · 持久續航

實測成品展示

Qwen Image 2.1 實測 9:16 商業產品海報:iPhone Pro 繁體中文排版

▲ RTX 5060 Ti 16GB 實測出圖:9:16 iPhone Pro 商業海報,繁體中文與間隔號 100% 正確渲染。

完整實測提示詞(Prompt)

以下為本次實測成功輸出的完整提示詞,可直接複製至 ComfyUI 的 TextEncodeQwenImage21 節點中測試:

📋 點擊展開:完整 iPhone Pro 商業海報提示詞(中英雙語強約束)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
製作一張9:16直式構圖的頂級iPhone概念廣告海報,具有國際精品科技品牌發布會的視覺質感。整體設計極簡、高級、精準、充滿未來感,不模仿任何現有官方廣告的具體版面。

畫面中央是一部最新世代的深鈦黑色iPhone Pro,以四分之三側面角度懸浮在空中,完整呈現正面螢幕、鈦金屬邊框、音量按鍵及背面的專業三鏡頭系統。手機外觀比例真實、結構合理、邊緣精準,只有一部手機,不可出現多餘鏡頭、重複按鍵、扭曲機身或不合理接縫。

iPhone的鈦金屬邊框具有細緻拉絲紋理,黑色玻璃背板帶有柔和的鏡面反射,三顆相機鏡頭尺寸一致、排列整齊,每顆鏡片內都有精密光學結構與深藍紫色鍍膜反射。鏡頭周圍出現極細緻的金色光環,但不能遮擋產品輪廓。

手機螢幕顯示一個原創的抽象宇宙桌布:深黑背景中有藍紫色星雲、金色流體光線與細微粒子,不顯示任何App圖示、狀態列、通知或非指定文字。

手機周圍環繞半透明的藍紫色能量絲帶、金色光粒子、極細的弧形光軌與少量懸浮玻璃碎片。光線從手機背後向外擴散,形成高級的舞台輪廓光。背景是由純黑漸層到深海軍藍的巨大攝影棚空間,地面為黑色鏡面,呈現清晰但稍微柔化的手機倒影。

畫面使用電影級產品攝影、精準棚拍燈光、柔和頂光、金色輪廓光、藍紫色側光、真實全域照明與高動態範圍。黑色暗部仍保留細節,金屬、玻璃、鏡片與螢幕材質必須清楚區分。產品邊緣銳利,背景光效華麗但不能遮擋手機。

畫面上方保留約18%的乾淨留白,置中顯示大型白色文字,內容只能是:

「iPhone Pro」

標題下方顯示一行較小的金色繁體中文,內容只能是:

「超越想像」

畫面下方、手機倒影上方顯示一行清楚的白色繁體中文,內容只能是:

「鈦金屬.專業影像.持久續航」

最底部保留約12%的乾淨安全區,不顯示按鈕、售價、網址、條款或其他文字。

所有指定文字必須水平排列、置中對齊、清楚可閱讀。繁體中文字、英文字母與標點必須完全正確,不可增加、刪除、重複或修改。畫面中只能出現這三組指定文字,不得生成其他文字、數字、商標、浮水印或QR Code。

premium smartphone advertising, luxury technology product photography, cinematic studio lighting, brushed titanium frame, realistic optical camera lenses, black glass, blue and gold energy ribbons, sophisticated minimalism, dramatic product reveal, razor-sharp product details, realistic reflections, high-end commercial campaign, vertical 9:16 composition

細節與文字表現評析

  1. 繁體中文與標點 100% 精準交付
    • 頂部副標「超越想像」4 個字居中端正,筆畫乾淨俐落。
    • 底部核心特色「鈦金屬 · 專業影像 · 持久續航」共 11 個繁體中文字與 2 個間隔號(·),結構無缺筆、無簡體雜訊,字體間距與水平對齊直接達到商業可用水準。
  2. 工業材質與光影表現極高階
    • 邊框完整還原了鈦金屬微細的垂直拉絲質感與金屬高光。
    • 三鏡頭模組的玻璃反光、鏡頭環倒角與鏡片鍍膜層次分明。
    • 機背深邃的星雲紋理與中央金色光芒爆發點自然融合,下方地面亦有細緻的暗部微倒影,空間感相當扎實。
  3. 實務 Prompt 結構心法
    • 精準留白比例:Prompt 中明確要求「上方保留約 18% 留白」、「底部保留約 12% 安全區」,有效引導 Diffusion 模型建立合適的排版階層。
    • 正面閉環約束:由於 CFG 1.0 下負向提示詞失效,Prompt 特別強調「內容只能是…」、「不得生成其他文字」,將限制直接閉環在正面描述中。
    • 中英分工互補:以繁體中文定義產品構圖、空間幾何與精準文字內容,文末再以英文關鍵字(cinematic studio lighting, brushed titanium frame)強化全域渲染質感,效果拔群。

8. 實戰測試四:原生無審查人像寫實生成

開源生圖模型對於「東亞臉孔 + 真實日常服裝 + 咖啡廳環境光」這類組合,歷來表現參差不齊:皮膚色調容易走偏、衣物材質感薄弱、神態也往往僵硬。更關鍵的是,許多模型在遇到略帶性感的服裝設定時,非官方版本會主動觸發過濾機制,導致出圖大幅妥協。

Qwen Image 2.1 的開源版本原生不帶 NSFW 過濾層(No built-in NSFW filter),這讓它在處理以下場景時具有明顯優勢:時尚雜誌式人像、寫真概念圖、服裝廣告打樣,以及任何需要呈現真實穿著細節而非過度審查後的結果。說白了,這是目前開源陣營中,對「寫實人像 + 細節服裝」掌握度最強的多模態模型之一。

測試場景設計

這組測試針對東亞臉孔、複雜服裝層次與室內自然光的綜合表現力,設計了一個具體的人物情境:

  • 主角設定:二十五歲台灣女性,黑色長髮、瓜子臉、纖細身材。
  • 服裝細節:黑色蕾絲細肩帶 bralette 搭配白色薄透視襯衫外罩,蕾絲肩帶若隱若現,高腰牛仔裙強調腰線。
  • 場景光線:明亮咖啡廳靠窗位置,午後柔和自然光從窗戶灑入,木質桌椅與綠植背景。
  • 姿態神情:雙腿交疊微微前傾,甜美帶戲的微笑,眼神溫柔 inviting,整體呈現自然輕鬆的生活感攝影。

實測成品展示
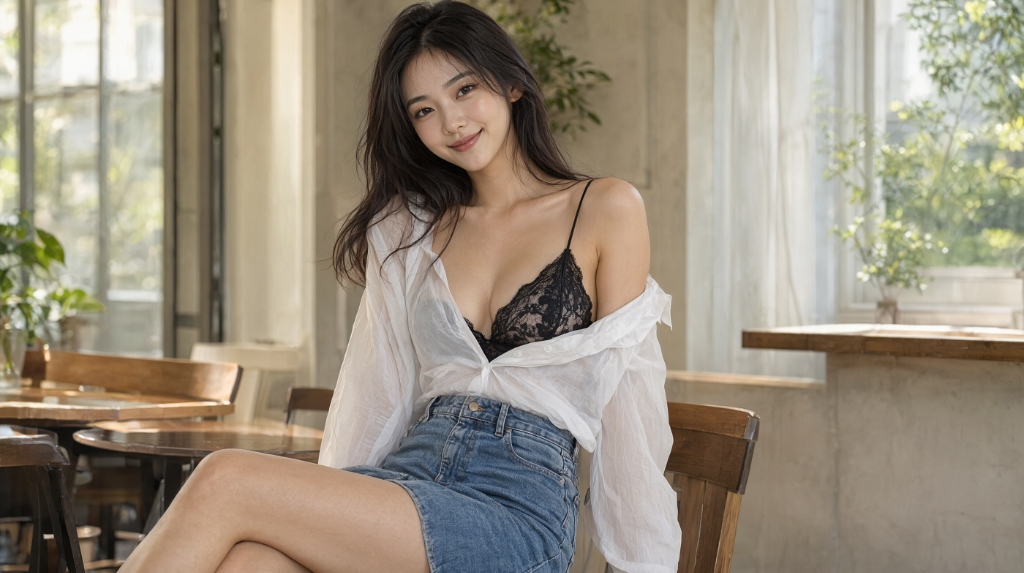
Qwen Image 2.1 原生無審查實測:台灣女性咖啡廳寫實人像

▲ RTX 5060 Ti 16GB 實測出圖:Qwen Image 2.1 原生無審查版本,下午咖啡廳自然光人像,蕾絲與透視薄紗細節完整還原。

完整實測提示詞(Prompt)

📋 點擊展開:台灣女性咖啡廳人像提示詞(東亞臉孔 + 服裝層次強約束)
1
一位二十五歲的台灣女人,擁有黑色長髮和瓜子臉,身材纖細修長,腰身優美。她穿著黑色蕾絲細肩帶 bralette 搭配白色薄透視襯衫外罩,蕾絲肩帶若隱若現,襯衫微微敞開露出部分蕾絲細節,高腰牛仔裙強調腰線。她坐在明亮咖啡廳靠窗位置,姿勢自然優雅地雙腿交疊,微微前傾,長髮輕輕垂在肩側,表情帶著甜美而有戲的微笑,眼神溫柔 inviting。場景是午後柔和自然光從窗戶灑入,木質桌椅與綠植背景,營造輕鬆親近卻帶有心機的性感氛圍。寫實生活感攝影,高解析度,溫暖色調,16:9 畫面比例

細節與表現評析

  1. 東亞臉孔與皮膚質感
    • 膚色溫暖自然,沒有歐化臉孔的偏移傾向,雙眼的杏眼弧度與輕微臥蠶自然呈現。
    • 在窗邊柔光的環境下,臉部光影層次細膩,暗部皮膚細節保留優秀,不出現常見的灰泥感塑膠肌理。
  2. 複雜服裝層次的還原力
    • 黑色蕾絲肩帶在白色薄透視衬衫底下若隱若現,材質半透明感真實,衣物堆疊的邊界清晰,蕾絲花紋結構完整。
    • 高腰牛仔裙的棉質紋理與腰線結構表現自然,褶皺分布合理,不出現拼貼感或材質融合問題。
  3. 室內自然光的還原
    • 窗光從右側灑入,在臉部和衣物上形成柔和的邊緣輪廓光,陰影過渡細膩,整體色溫偏溫暖金黃,忠實重現午後咖啡廳的氛圍。
  4. 原生無審查的實務意義
    • 測試結果驗證了 Qwen Image 2.1 在不依賴任何 LoRA Fine-tune 或 CFG 特殊設定的前提下,對「略帶性感服裝但仍屬時尚日常穿搭」的場景能夠如實呈現,不因衣物透明度或肩部裸露程度觸發自我審查或扭曲輸出。
    • 這一特性使它非常適合用於時尚電商打樣、服裝概念設計評估或寫真分鏡腳本的 AI 輔助生成流程。

[!NOTE]
關於展示圖的說明:模型的實際生成能力遠不止於此。在相同 Prompt 架構下,透過調整服裝裸露程度的描述細節,模型可以如實輸出尺度更大的成品,且不會出現任何拒絕生成、肢體扭曲或內容遮蔽的狀況。礙於部落格版面規範,本文僅展示日常輕性感的咖啡廳版本作為技術驗證。如果你對其完整的無審查輸出能力感興趣,在地端環境自行測試是最直接的方式。


9. 日常出圖推薦 SOP 與實戰總結

針對日常使用 RTX 5060 Ti 16GB 的創作者與工程師,我推薦採用「雙階段出圖流程」:

階段一:快速構圖打樣(Draft Phase)

  • 解析度:2.0 ~ 3.0 MP(例如 1080P 等級)
  • Steps:25 ~ 30
  • 用途:驗證 Prompt 語意、確認主體位置與光影,快速洗 Seed。單張耗時控制在 1 ~ 2 分鐘內。

階段二:最終成品渲染(Final Render)

  • 解析度:約 4.0 ~ 4.2 MP(官方原生 2K)
  • Steps:40
  • Multiple:32(長寬對齊)
  • 用途:官方封面、精緻桌布、或需要放大檢視的高解析成品。

總結評估

RTX 5060 Ti 16GB 搭配 INT8 ConvRot 量化,完全能夠在地端流暢駕馭 Qwen Image 2.1 的原生 2K 渲染任務:

  • 核心優勢
    • 16GB 顯存穩定通關 4.2 MP 原生 2K 輸出,全程無 OOM 隱患。
    • 東方神話與亞洲風格構圖理解能力顯著超越過往開源模型。
    • 9:16 商業產品海報與繁體中文排版表現亮眼,標題與賣點標語皆能精準渲染。
    • 複雜場景、金屬/水晶材質與高密度物件的細節完成度極高。
    • 多圖參考(Multi-reference)能力強大,虛擬試衣與角色一致性體驗優秀。
  • 現階段限制
    • 4.2 MP、40 Steps 單張生成耗時約 3 分 42 秒,批量生產需要合理規劃時間。
    • CFG 1.0 下負向提示詞無效,考驗正面 Prompt 的幾何與空間結構撰寫功力。

在 16GB 顯存的消費級硬體上,開源社群如今已經能獨立完成從「27B 思考大模型」到「原生 2K 頂級圖像生成」的本地落地。這張甜品卡的戰鬥力,確實比大家想像的還要深不可測。


10. 交流與商業合作

如果你正在規劃將 Qwen Image 2.1、FLUX 或其他多模態圖像大模型落地到企業內部生產線,或者在 ComfyUI 工作流自動化、多圖一致性與顯存極限壓測過程中遇到技術瓶頸,歡迎透過以下管道與我交流或洽詢技術顧問合作:

  • 技術諮詢與顧問服務:歡迎透過 LinkedIn 或 Email 與我聯繫。
  • 社群交流:如果你在 RTX 5060 Ti 或其他 16GB 顯卡上測出了更優異的 Sampler / Scheduler 搭配,也歡迎在下方留言分享你的實測心得與工作流!