[實戰解析] OMP 模型路由配置:CommandCode GOAT 搭配 ChatGPT Plus 的高性價比解法
在全端開發中,同時推進後端 API、Web 前端與 Android App 時,多工並行能大幅節省時間。最近我在 Oh My Pi (OMP) 裡配置多個 Subagent 協助開發,遇到最核心的問題就是:如何合理分配模型資源,兼顧程式碼品質與使用成本?
許多人使用 OMP 會直覺串接 Claude,但我考量到 Claude 官方對第三方終端工具的存取抓得很嚴,許多開發者都遇到帳號被 Ban 的情況。為了環境穩定,我選擇以已登入的 openai-codex 連線為主,並搭配平價的 10 美元包月方案來消化日常大量寫碼的需求。
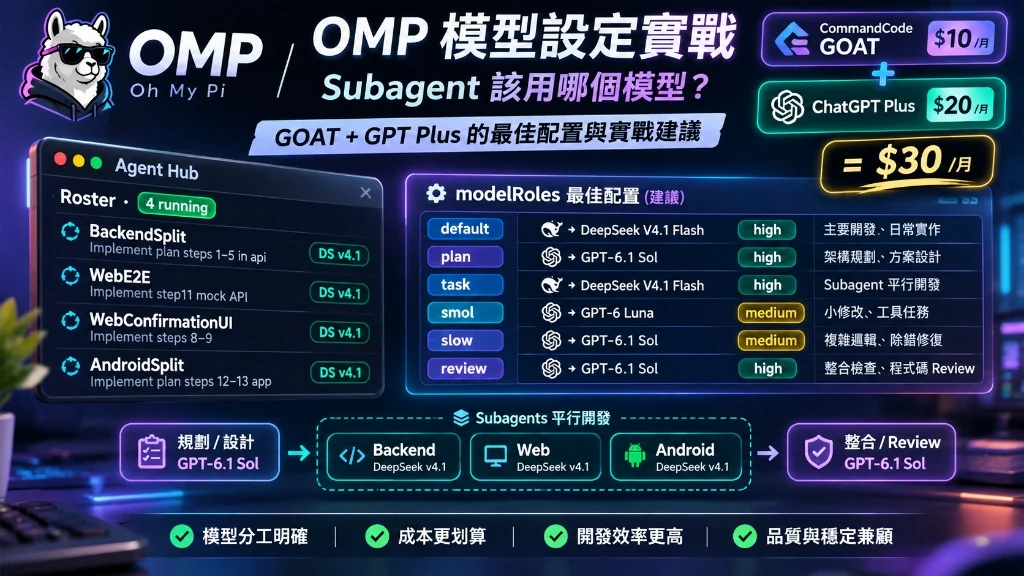
這篇文章記錄我目前採用的雙軌配置邏輯,並深入說明 OMP Subagent 的設定細節與推理降級的排查方式。
為什麼這樣選?訂閱考量與風險權衡
在模型選用上,我建議將任務拆分為兩種獨立的訂閱服務,彼此互補:
1. 避開風險:以 ChatGPT Plus(Codex)承擔核心任務
- 避免封號風險:Claude 雖然程式能力出色,但直接接入終端工具風險較高。相比之下,使用 ChatGPT Plus 登入
openai-codex運作穩定許多。 - 高價值任務專用:GPT-6.1 Sol 具備優異的架構理解與嚴謹度,適合留給整體專案的架構規劃(Plan)、疑難雜症排查(Slow)以及代碼合併前的審查(Review)。
2. 成本槓桿:以 10 美元方案消化 80% 寫碼流量
- 高性價比方案:目前市面上無論是 CommandCode GOAT 還是 OpenCode Go,每月 10 美元的月費都能享有等值 100 美元的模型額度,等於具備 10 倍的槓桿。
- 十分之一的開發成本:將大量且瑣碎的日常寫碼、修改、單元測試交給 DeepSeek V4.1 Flash。以實質十分之一的費用處理日常 80% 的寫碼流量,即使多個 Subagent 同時並行,也不用擔心成本失控。
剖析 OMP Subagent:為什麼思考等級全部變成 low?
剛開始設定 OMP 時,不少人會發現啟動的子代理(Subagent)思考強度(Thinking Level)全部都是 low,甚至誤以為是模型不支援較高的推理強度。
查閱 OMP 原始碼(packages/coding-agent/src/task/agents.ts)後,能看到內建子代理的定義:
1 | { name: "task", model: "@task", thinkingLevel: AUTO_THINKING } |
從源碼可以釐清以下三點底層邏輯:
modelRoles.default不直接控制子代理:default主要是主交談介面所使用,內建一般用途的 Subagent 讀取的是modelRoles.task。thinkingLevel: AUTO_THINKING的預設行為:OMP 會自動評估任務複雜度來決定推理強度。如果沒有特別限制,系統常會自動判定以low執行,這是 OMP 內部機制的判斷,跟模型本身無關。- 手動覆蓋強度:若希望子代理維持較高的推理品質,可以在模型標籤後方明確加上
:high或:medium,並搭配關閉自動推理調節。
OMP 多 Agent 協同架構
透過合理的角色分工,整體的開發流程如下:
    flowchart TD
    subgraph Plan_Phase ["規劃階段"]
        P["GPT-6.1 Sol (high)<br/>role: plan"] --> Spec["生成介面規範與任務清單"]
    end

    subgraph Task_Phase ["多端並行實作 (Concurrency: 4)"]
        Spec --> B["Backend 模組<br/>DeepSeek V4.1 (high)"]
        Spec --> W["Web 前端模組<br/>DeepSeek V4.1 (high)"]
        Spec --> A["Android 模組<br/>DeepSeek V4.1 (high)"]
        Spec --> S["輕量修訂任務<br/>DeepSeek V4.1 (low)"]
    end

    subgraph Review_Phase ["整合審查階段"]
        B & W & A & S --> R["GPT-6.1 Sol (high)<br/>role: review"]
        R --> C["Git Commit<br/>@smol (DeepSeek low)"]
    end
OMP Subagent 設定教學與 config.yml 配置
在 ~/.omp/agent/config.yml 中,主要透過三個區塊來管理 Subagent 的行為:
modelRoles:定義抽象角色的模型與推理強度。task:設定子代理的並行數、覆蓋關係與推理鎖定。retry.fallbackChains:設定用量達上限時的備援鏈。
以下是建議採用的配置內容:
1 | # ~/.omp/agent/config.yml |
重點設定說明
task.agentModelOverrides(子代理角色映射):這裡控制的是 Agent 的類型而非任務名稱。例如一般的 task 工作就會走@task(即 DeepSeek high),而負責 Review 的子代理則走@review(即 GPT Sol high)。task.maxConcurrency: 4(並行數量限制):CommandCode GOAT 在 5 小時內有 20 美元的滑動限制,設定上限為 4 個並行任務,能避免短時間內暴衝超過速率限制。task.enableEffort: false(鎖定推理強度):避免 OMP 底層的AUTO_THINKING將 Subagent 降級,確保執行時維持在宣告的:high強度。fallbackOn: usage-limit(嚴格備援觸發):只有在遇到額度限制時才切換到備援鏈,避免一般網路逾時就無謂調用備用訂閱。
驗證設定與日常排查
設定完成後,可透過 OMP 內建指令檢查設定是否正確套用:
1 | # 檢查 Subagent 與相關配置 |
需要特別留意的是,修改設定檔後,變更只會作用在新啟動的 Subagent 上,已經在背景執行的任務不會中途更換模型。
結語
面對多 Agent 的開發流程,重點不在於全面換用最貴的模型,而是把資源分配在對的節骨眼上。
透過 ChatGPT Plus(Codex)處理架構規劃與代碼審查,不僅能維持專案品質,也避開了 Claude 接入終端的封號風險;同時利用 10 美元的平價方案(CommandCode GOAT 或 OpenCode Go)放大額度槓桿,以十分之一的成本支撐 80% 的寫碼任務,既經濟又實用。